史伟莎技术服务平台 / AI 协作研发
当代码可以快速生成,
项目怎样继续推进?
2026 年 7 月,我接手这个面向消杀技术人员的 iOS 服务平台,继续推进签到、工单、SOP 执行与签离等核心流程。
工程里已经有 AI 生成的界面与业务代码,但需求资料不完整,Demo、Mock 和正式接口之间缺少清楚的对应关系。继续开发前,我需要先核对哪些行为已经确认、哪些实现值得保留,以及每次修改应该止于哪里。
展开项目背景 史伟莎技术服务平台
完整实践 ↗
史伟莎技术服务平台 / AI 协作研发
2026 年 7 月,我接手这个面向消杀技术人员的 iOS 服务平台,继续推进签到、工单、SOP 执行与签离等核心流程。
工程里已经有 AI 生成的界面与业务代码,但需求资料不完整,Demo、Mock 和正式接口之间缺少清楚的对应关系。继续开发前,我需要先核对哪些行为已经确认、哪些实现值得保留,以及每次修改应该止于哪里。
展开项目背景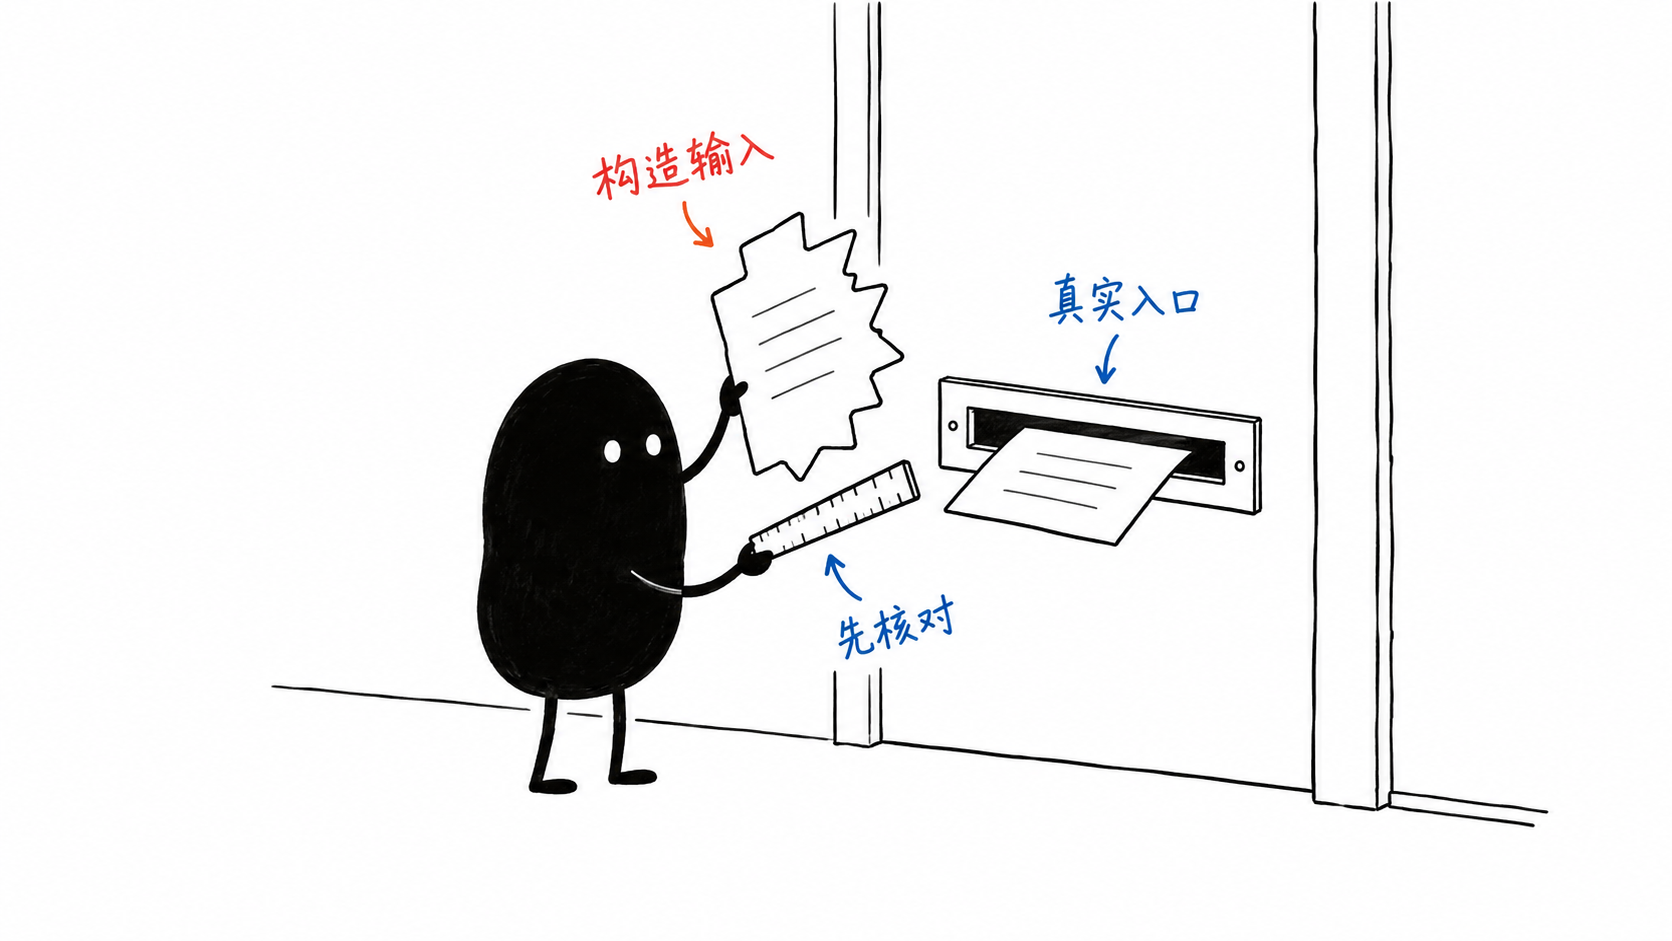
我借助 AI 调查、实现和审查,也逐渐发现:一个解释完整的结论,仍然需要回到触发条件和业务影响中核对。
在推进核心业务的同时,我逐步承担需求澄清、任务拆分、方案判断和质量把控。每次接受一项改动,都需要检查它是否符合已确认的规则,是否引入了额外行为。
2026 年 10 月 15 日,AI 用人为构造的异常数据证明处理存在风险,并将其列入必须修复的清单。我继续追问:正常操作能否产生这些输入?接口是否允许?会影响哪些业务资料?
重新核查后,正常操作可触发的问题、异常数据保护和未确认需求被分别处理。这次纠偏也成为后续审查的依据:认定缺陷,需要说明输入来源、支持范围和预期行为。
这些反复出现的问题,推动我将协作要求整理成可执行的约束:交代修改范围,重构时保持已确认行为,分别记录实际修改、验证结果和未验证范围。
阅读具体审核案例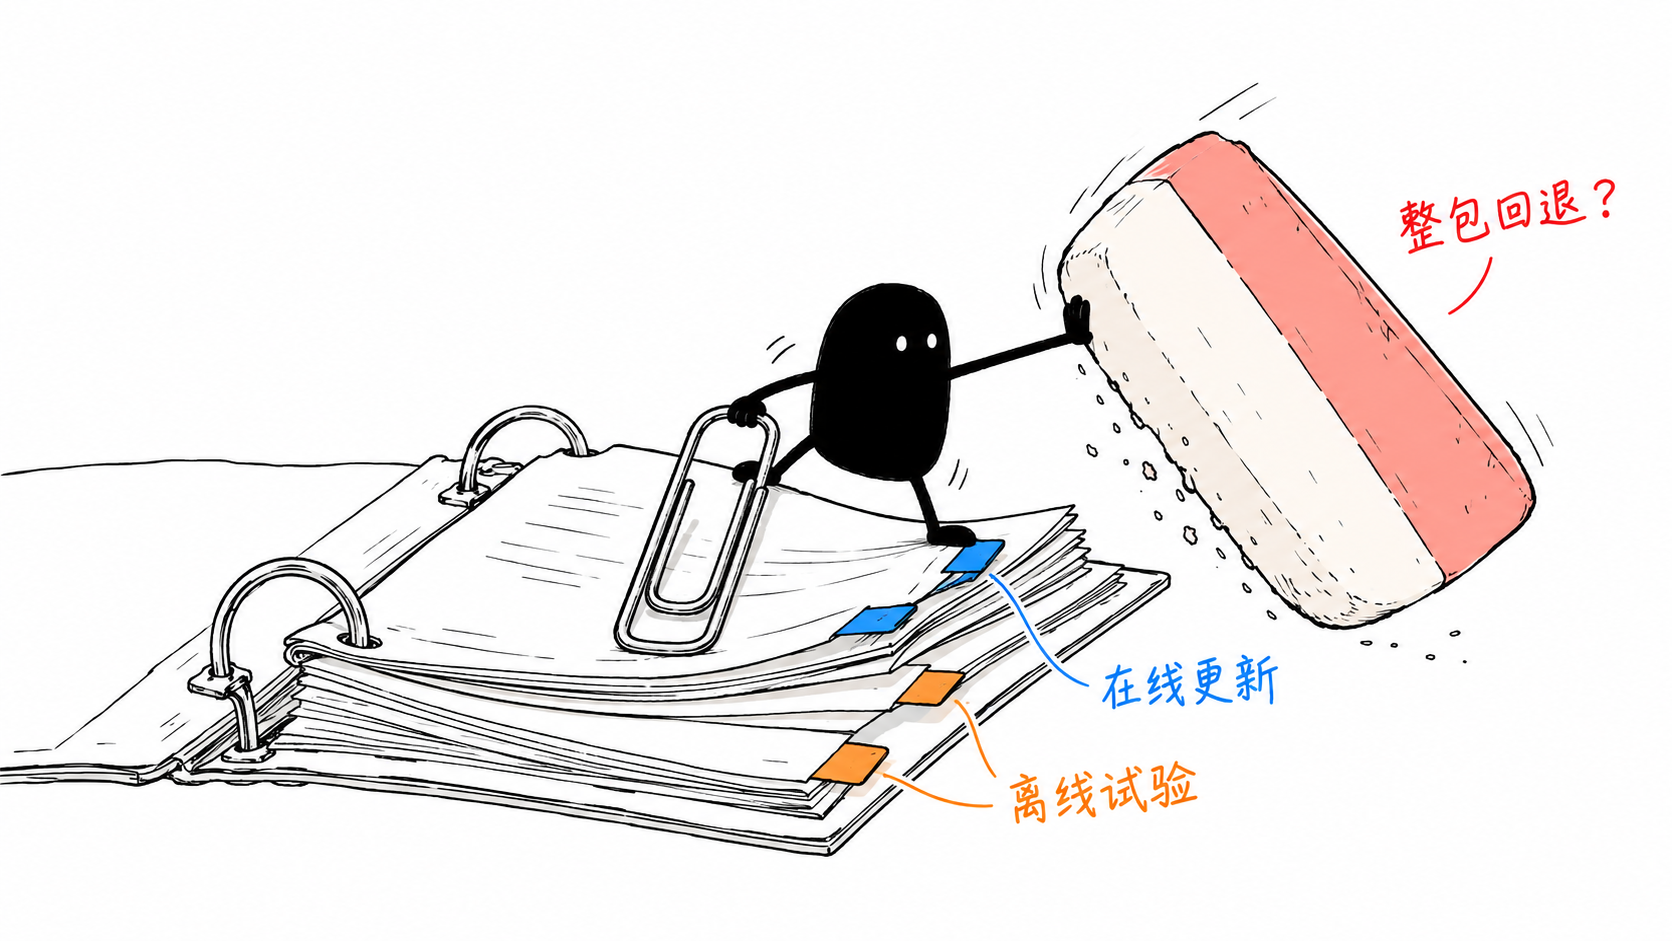
2026 年 10 月
业务调整要求优先推进在线版本,尚不成熟的离线功能需要快速剥离。
这时,离线分支已经混入发票、SOP 配置、签名、拍照定位等在线业务更新。直接回退旧分支,会把这些成果一起丢掉。
我将目标明确为:以既有在线行为为基准,在当前分支移除离线能力,同时保留已经确认的在线更新。工作因此需要追到每条业务链,辨认哪些行为应当保留,哪些状态和调用需要撤下。
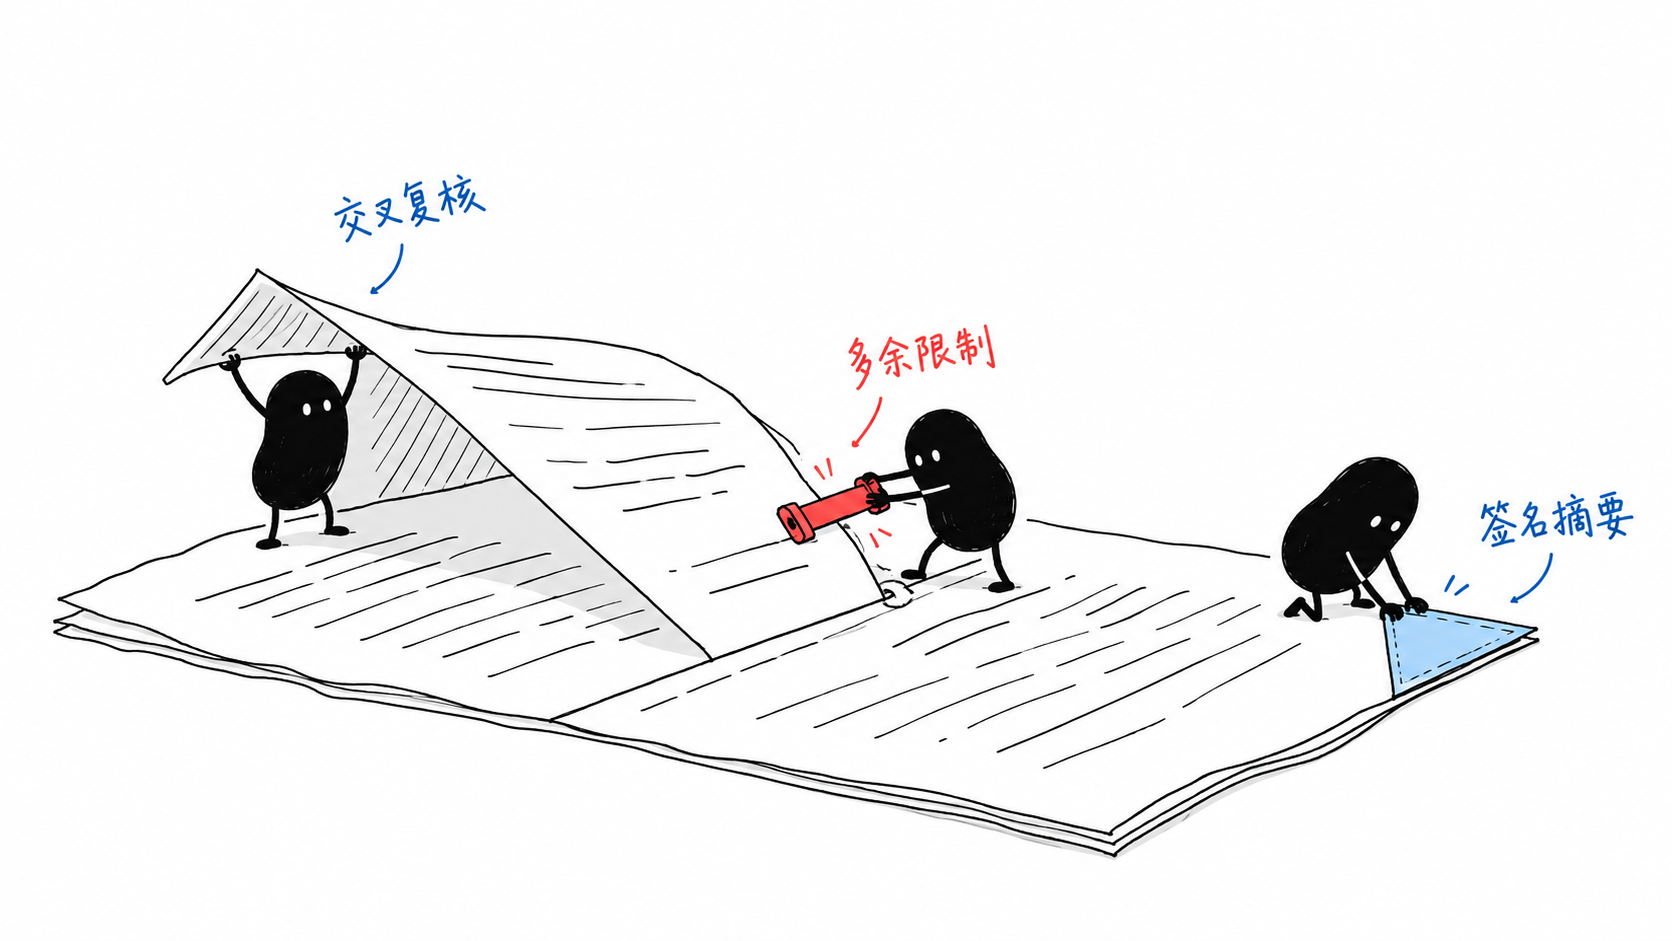
这次剥离把业务判断、AI 执行、交叉复核和夜间续办放进了同一条推进流程。
我先要求对比两个分支,按业务操作列出执行链,再将任务分步交给子代理。交接时说明已有结论、允许修改的文件和完成标准,主会话负责衔接与审查。
执行并没有一次结束。AI 曾将离线开发新增的集中提交校验当作普通校验保留,扩大了在线版本原有的限制。后续交叉核查又发现,客户签名的在线摘要需要恢复,物料保存条件需要纠正,离线投影字段仍有残留。
我继续追查这些逻辑的来源与调用方,安排不同角度的复核,逐项修正。10 月 17 日凌晨,通过分步执行与定时续办继续收尾,并预留额度支持后续核查。
这次经历也改变了我的删除审查方式:沿着业务行为检查保留项、恢复项和状态更新条件,才能看清混合变更中的影响。
展开离线剥离过程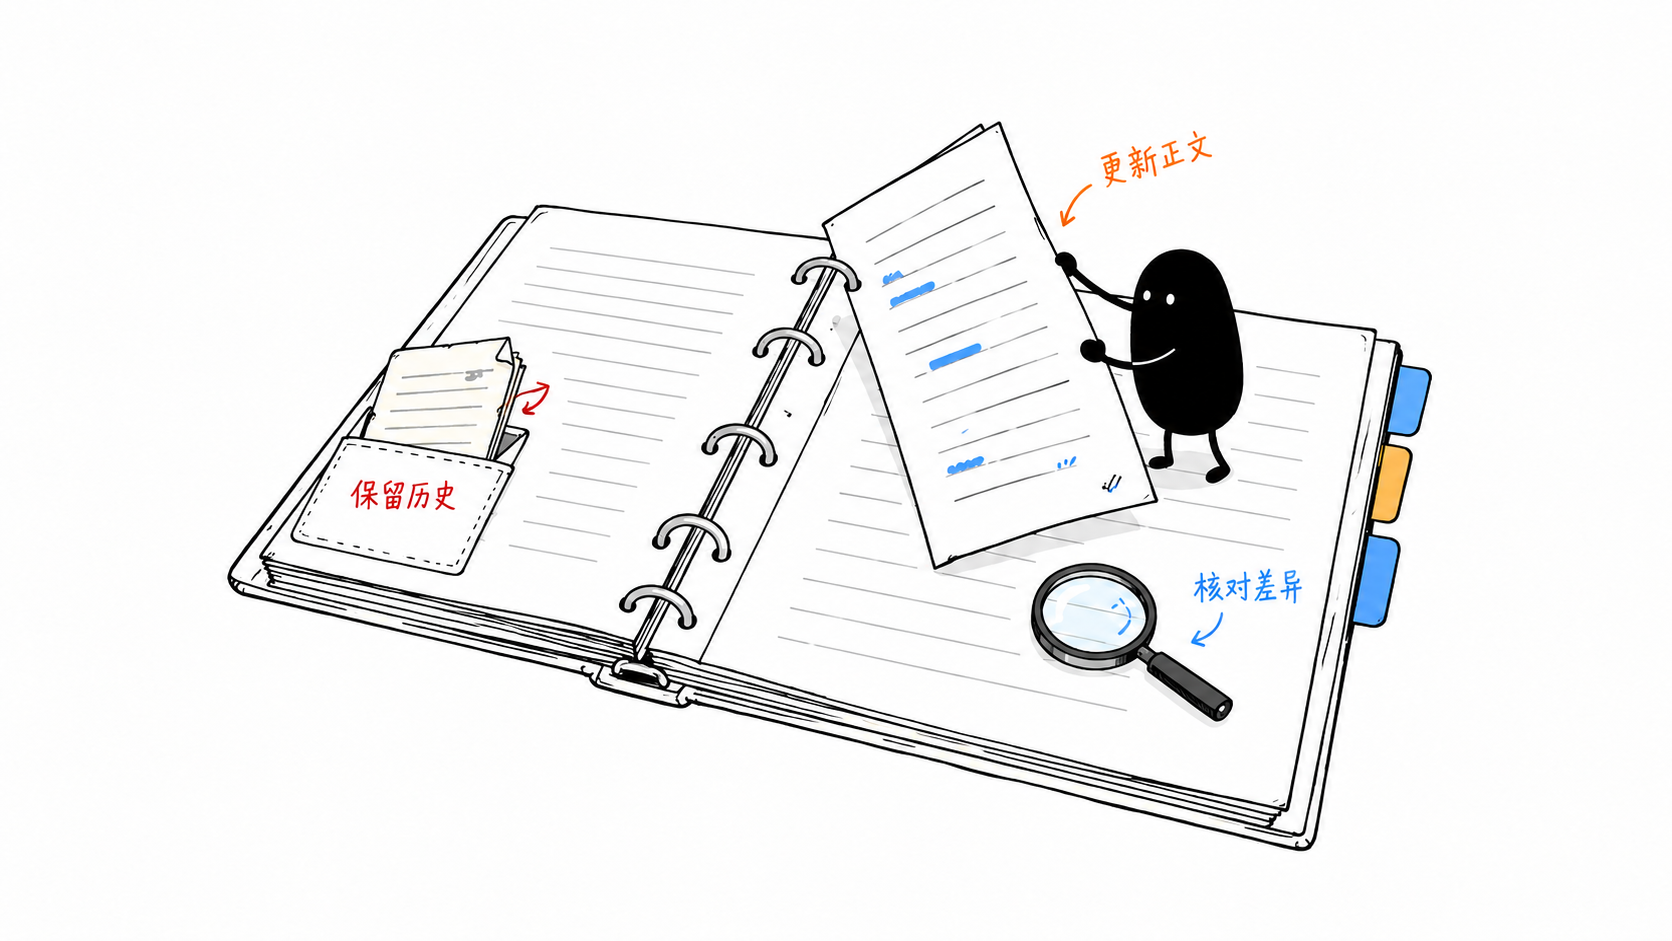
项目推进的同时,我把反复核实的业务、代码关系和有效约束整理下来,供后续任务继续查询与更新。
当时记录完成了 35 个源码文件的实际删除,修正物料、签名及模型残留问题,正式 Workspace 的 Debug、Release 编译和链接通过。
该记录仅对应当时版本与构建配置,业务界面和真实接口的验收需要另外确认。
已组织整理 23 份功能正文及对应变更历史,覆盖功能入口、流程、条件、接口、源码位置与核查范围。
相关文件变化后,结合 Git 差异与调用关系分析行为,再更新正文、历史和阅读页。知识库收录范围、待确认内容与实际运行状态分别保留依据。
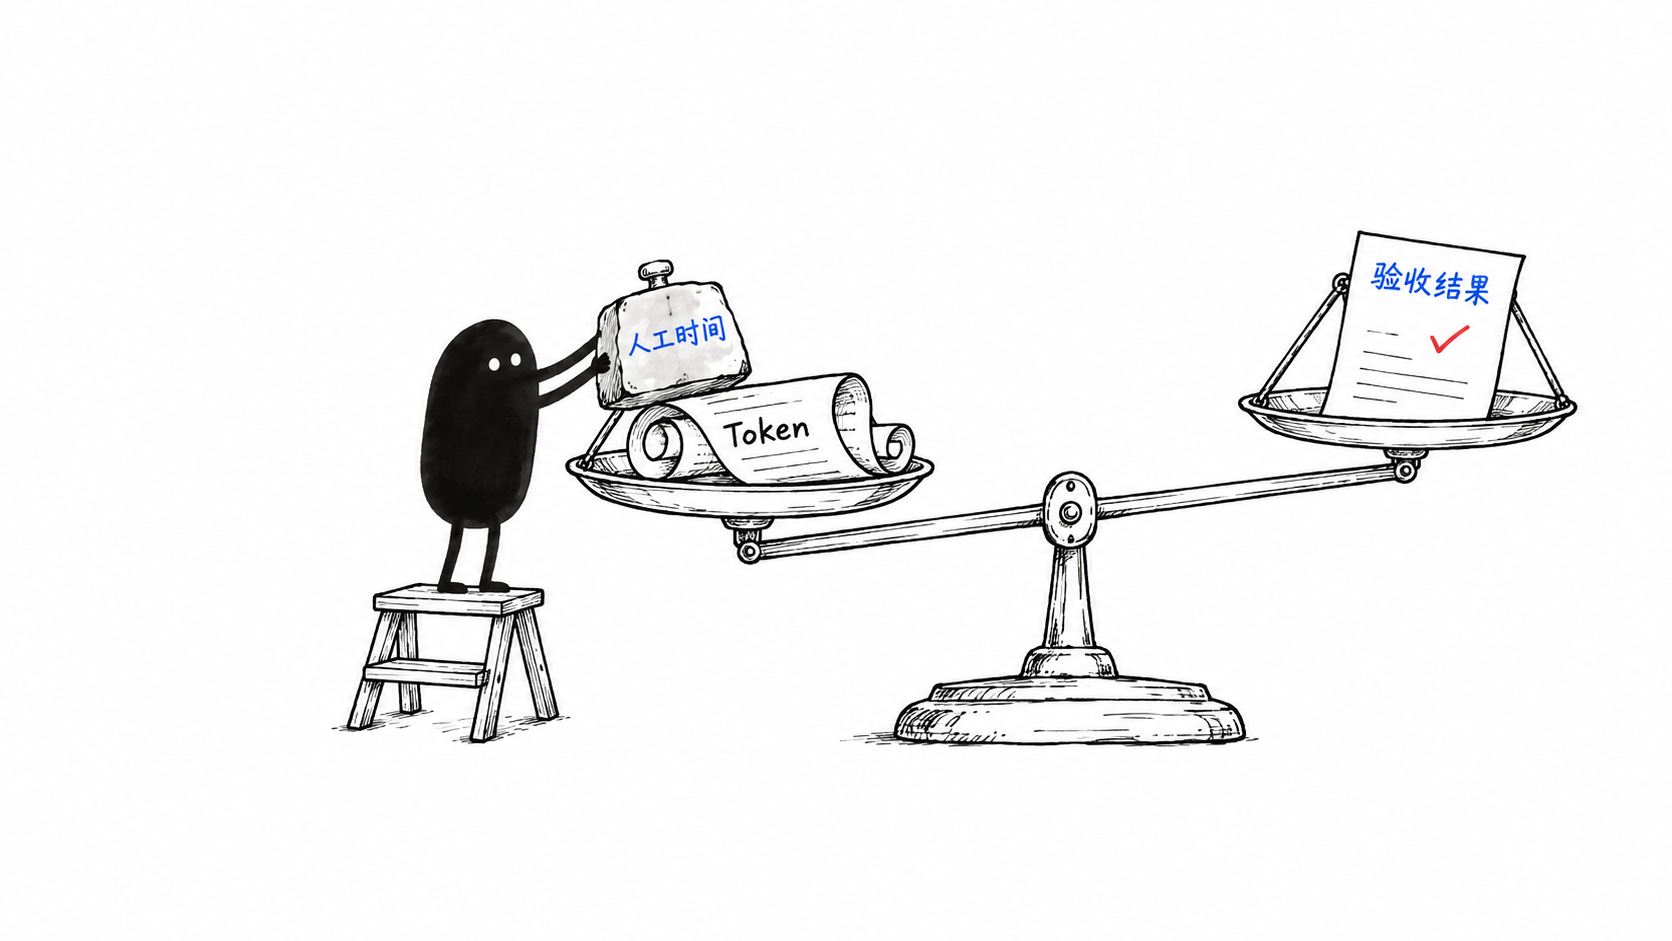
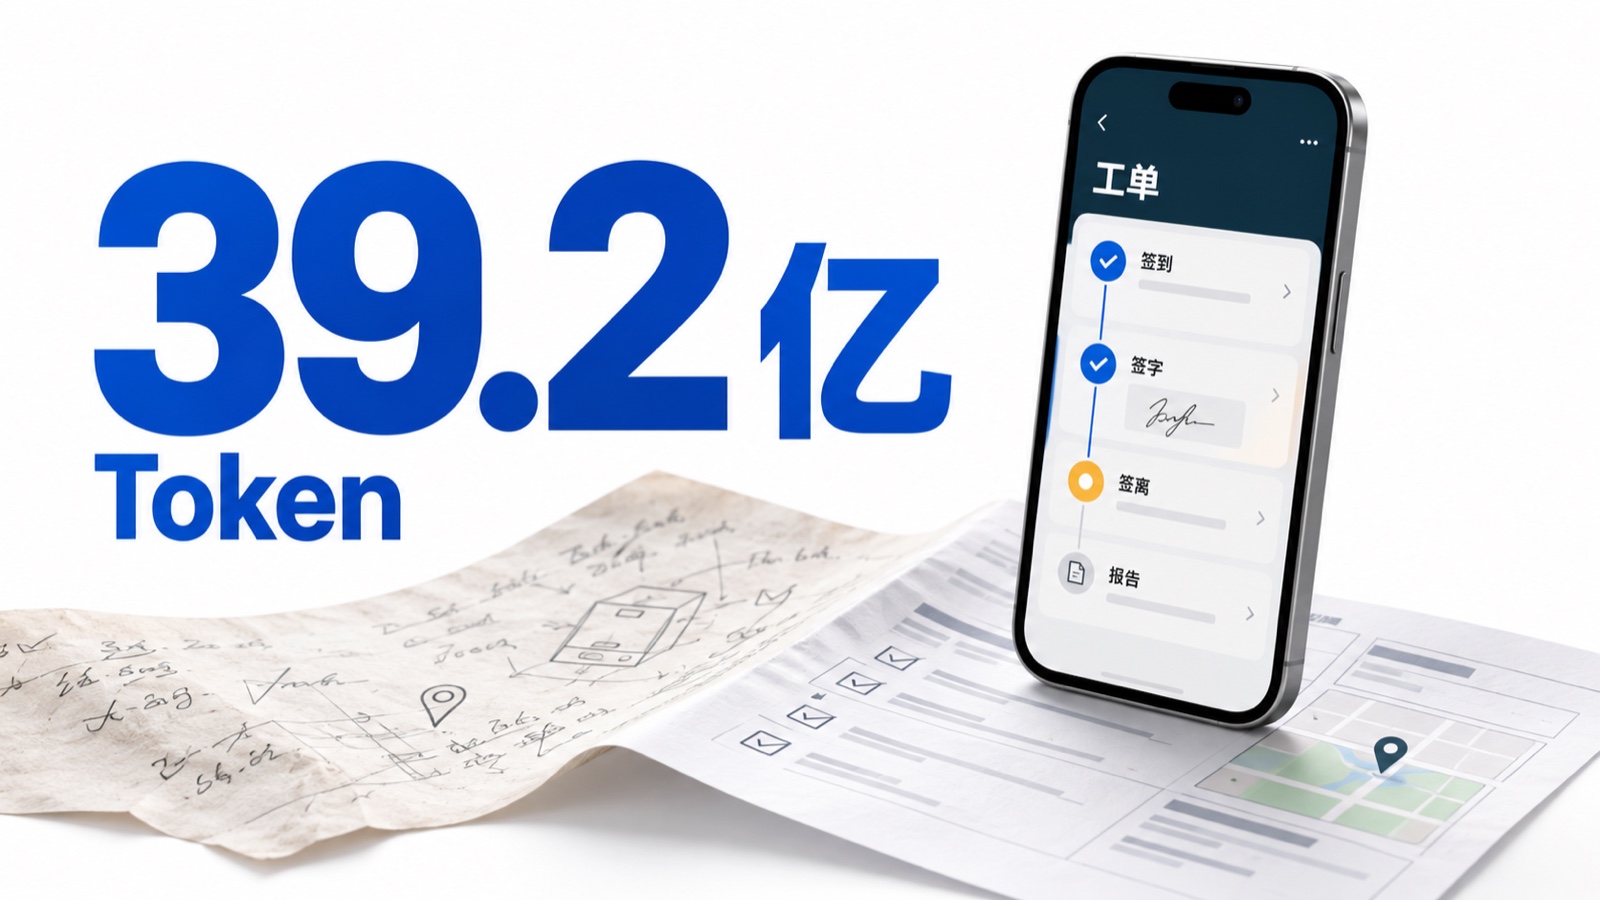
39.2 亿 Token 留下了累计记录。评价这段实践,还需要回到具体任务、人工参与和交付结果。
按面板口径,这个数字包含缓存复用。同一批历史对话、代码和工具结果,在多轮分析与审查中会继续计入累计 Token。95.6% 是输入缓存命中率,说明上下文的复用情况,不能直接用来证明效率提升。
在这个项目里,可以具体看到研发投入落在了哪些工作上:弄清业务依据,组织实现,发现错误保留与遗漏,修正偏差,再核对验证范围。多代理和夜间执行扩大了可处理的工作范围,也带来交接、等待和重复审查的成本。
把有效结论整理成规则与知识资料,是为了让后续任务能够复用。对于节省了多少 Token、人工时间或返工,目前还缺少统一的前后对照记录。
接下来,我会在相近的任务范围和验收标准下,比较 AI 成本、人工时间与返工量,继续判断哪些投入值得保留,以及怎样更早发现业务细节的变化。
查看统计口径与完整投入记录